AOR-Bench: Do Large Audio Language Models Over-Refuse Pseudo-Harmful Queries?
A benchmark for over-refusal in large audio language models — how often they decline pseudo-harmful but benign spoken queries, and what drives it.
jiaxi-yang
A benchmark for over-refusal in large audio language models — how often they decline pseudo-harmful but benign spoken queries, and what drives it.
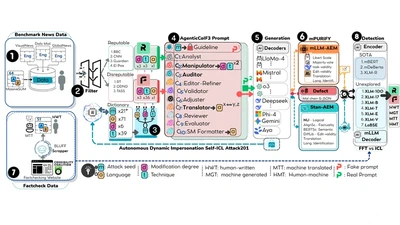
BLUFF is the largest multilingual fake news detection benchmark, spanning 79 languages with 202K+ samples. It introduces AXL-CoI for adversarial generation and mPURIFY for quality …
